Leetcode记录:排序算法
Table of contents
选择排序
选择排序是一种简单的排序算法,其基本思想是在待排序的序列中依次选出最小(或最大)的元素,存放到序列的起始位置,然后再从剩余未排序元素中继续寻找最小(或最大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
过程简单描述: 首先,找到数组中最小的那个元素,其次,将它和数组的第一个元素交换位置(如果第一个元素就是最小元素那么它就和自己交换)。其次,在剩下的元素中找到最小的元素,将它与数组的第二个元素交换位置。如此往复,直到将整个数组排序。这种方法我们称之为选择排序。
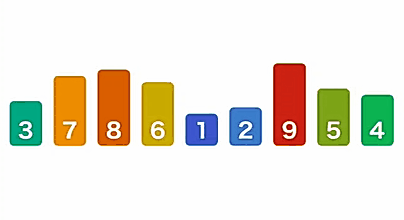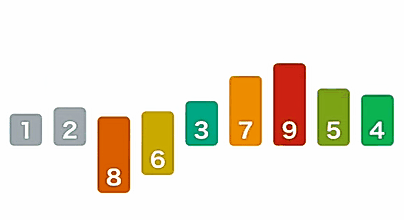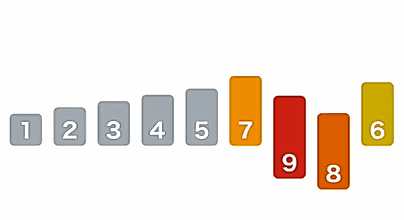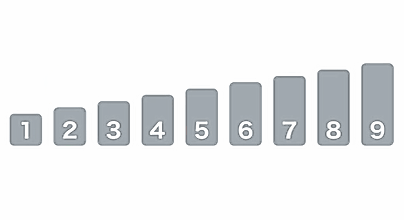
性质:
- 时间复杂度:$O(n^2)$
- 空间复杂度:$O(1) $
- 非稳定排序:在交换元素的时候可能会把前面的交换到后面。
- 原地排序
算法实现:
void selectionSort(vector<int>& arr) {
    int n = arr.size();
    for (int i = 0; i < n - 1; i++) {
        // 将当前位置设置为最小值的索引
        int minIndex = i;
        for (int j = i + 1; j < n; j++) {
            // 在未排序的元素中找到最小值的索引
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }
        // 如果找到一个索引不等于当前的最小值索引,交换它们
        if (minIndex != i) {
            swap(arr[i], arr[minIndex]);
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def selection_sort(nums):
    for i in range(len(nums)):
        smallest = min(range(i, len(nums)), key=nums.__getitem__)
        nums[i], nums[smallest] = nums[smallest], nums[i]
    return nums
冒泡排序
冒泡排序是一种简单的排序算法,它重复地走访过要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小(或越大)的元素会经由交换慢慢“浮”到数列的顶端,就像水中的气泡一样上升到水面。
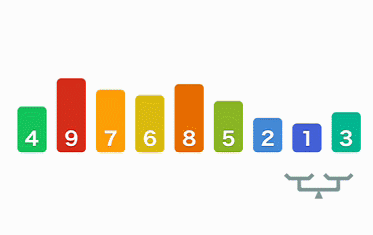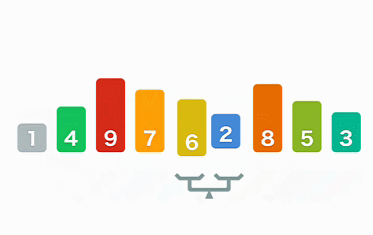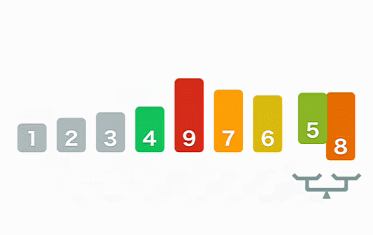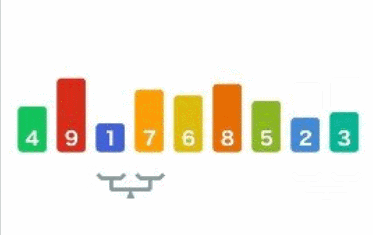
冒泡排序流程:
- 首先比较数组中的相邻两个元素。如果第一个比第二个大,则交换这两个元素的位置。这样,较大的数就会逐渐“浮”到数组的末尾。
- 接下来,对数组进行下一轮比较,从开始到结尾,但排除已经排序好的最大数。这一轮中,较大的数会被继续交换到数组的末尾。
- 持续进行上述步骤,直到整个数组有序排列。在每一轮中,都会有一个元素被“冒泡”到正确的位置。
性质:
- 时间复杂度:$O(n^2)$
- 空间复杂度:$O(1)$
- 稳定排序
- 原地排序
算法实现:
void bubbleSort(vector<int>& arr) {
    int n = arr.size();
    for (int i = 0; i < n - 1; i++) {
        // flag用于标记这次循环是否发生了交换
        bool flag = false;
        for (int j = 0; j < n - i - 1; j++) {
            if (arr[j] > arr[j + 1]) {
                // 如果当前元素比后一个元素大,则交换它们
                swap(arr[j], arr[j + 1]);
                flag = true; // 发生了交换,将flag设置为true
            }
        }
        // 如果这次遍历没有发生交换,说明数组已经有序,直接跳出循环
        if (!flag) {
            break;
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def bubble_sort(nums):
    for end in range(len(nums) - 1, 0, -1):
        changed = False
        for i in range(end):
            if nums[i] > nums[i + 1]:
                nums[i], nums[i + 1] = nums[i + 1], nums[i]
                changed = True
        if not changed:
            break
    return nums
插入排序
插入排序是一种简单直观的比较排序算法,它的工作原理是构建有序序列。它通过将元素插入到已经排序好的序列中来进行排序。这个算法在实践中对于小数组或部分有序的数组往往表现得非常好。
过程简单描述:
- 从数组第2个元素开始抽取元素。
- 把它与左边第一个元素比较,如果左边第一个元素比它大,则继续与左边第二个元素比较下去,直到遇到不比它大的元素,然后插到这个元素的右边。
- 继续选取第3,4,…,n个元素,重复步骤2,选择适当的位置插入。
性质:
- 时间复杂度:$O(n^2)$
- 空间复杂度:$O(1)$
- 稳定排序
- 原地排序
算法实现:
void insertionSort(vector<int>& arr) {
    int n = arr.size();
    for (int i = 1; i < n; i++) {
        int key = arr[i]; // 当前要插入的元素
        int j = i - 1; // 已经排序好的序列的最后一个元素的索引
        // 将比key大的元素往后移动
        while (j >= 0 && arr[j] > key) {
            arr[j + 1] = arr[j]; // 移动元素
            j--; // 向前移动索引
        }
        // 将key插入到正确的位置
        arr[j + 1] = key;
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def insertion_sort(nums):
    for i in range(1, len(nums)):
        value, j = nums[i], i - 1
        while j >= 0 and nums[j] > value:
            nums[j + 1] = nums[j]
            j -= 1
        nums[j + 1] = value
    return nums
希尔排序
希尔排序是插入排序的变种,它的基本思想是将待排序的记录序列分割成若干个子序列,每个子序列都是由相隔某个“增量”的记录组成的。然后对这些子序列分别进行直接插入排序,接着逐步缩小增量,直到整个序列变得“基本有序”,最后对全体记录进行一次直接插入排序以完成排序。
算法实现:
void shellSort(vector<int>& arr) {
    // 初始化增量为数组长度的一半
    for (int gap = arr.size() / 2; gap > 0; gap /= 2) {
        // 对每个子数组进行直接插入排序
        for (int i = gap; i < arr.size(); i++) {
            int temp = arr[i];
            int j;
            // 比较相距gap的元素,并交换位置
            for (j = i; j >= gap && arr[j - gap] > temp; j -= gap) {
                arr[j] = arr[j - gap];
            }
            arr[j] = temp;
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def shell_sort(nums):
    gap = len(nums) // 2
    while gap:
        for i in range(gap, len(nums)):
            value, j = nums[i], i
            while j >= gap and nums[j - gap] > value:
                nums[j] = nums[j - gap]
                j -= gap
            nums[j] = value
        gap //= 2
    return nums
性质:
- 时间复杂度:$O(n\log n)$
- 空间复杂度:$O(1) $
- 非稳定排序: 虽然插入排序是稳定的,但是希尔排序在插入的时候是跳跃性插入的,有可能破坏稳定性。例:7558->5578.
- 原地排序
归并排序
归并排序是一种分而治之的算法,它将数组分割成更小的数组,然后将它们排序,最后将排序后的数组合并。归并排序的一个优点是它是稳定的,并且有很好的性能。
归并排序流程:
- 分解:将数组分为两部分,如果数组长度为n,则分为n/2和n/2的两部分
- 归并:对每一部分进行归并排序,即从小到大排序。
- 合并:将排序好的两部分合并为一个有序的整体。
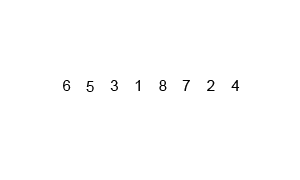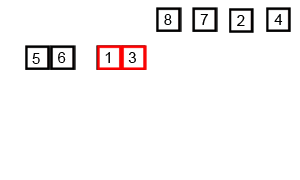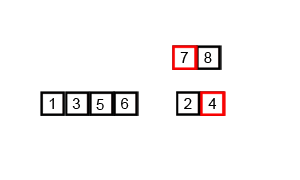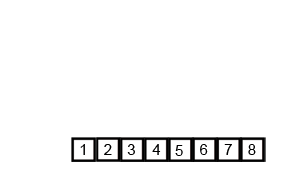
算法实现:
void merge(vector<int>& arr, int left, int mid, int right) {
    int n1 = mid - left + 1; // 左侧子数组的大小
    int n2 = right - mid; // 右侧子数组的大小
    // 创建临时数组
	vector<int> L(n1), R(n2);
    // 复制数据到临时数组中
    for (int i = 0; i < n1; i++)
        L[i] = arr[left + i];
    for (int j = 0; j < n2; j++)
        R[j] = arr[mid + 1 + j];
    // 合并临时数组
    // 初始化索引
    int i = 0;
    int j = 0;
    int k = left;
    while (i < n1 && j < n2) {
        if (L[i] <= R[j]) {
            // 稳定排序
            arr[k] = L[i];
            i++;
        } else {
            arr[k] = R[j];
            j++;
        }
        k++;
    }
    // 复制剩下的元素
    while (i < n1) {
        arr[k] = L[i];
        i++;
        k++;
    }
    // 复制剩下的元素
    while (j < n2) {
        arr[k] = R[j];
        j++;
        k++;
    }
}
// 归并排序的主函数
void mergeSort(vector<int>& arr, int left, int right) {
    // 如果 left == right,表示数组只有一个元素,则不用递归排序
    if (left < right) {
        int mid = left + (right - left) / 2;
        // 对左侧子数组进行归并排序
        mergeSort(arr, left, mid);
        // 对右侧子数组进行归并排序
        mergeSort(arr, mid + 1, right);
        // 合并两个已排序的子数组
        merge(arr, left, mid, right);
    }
}
性质:
- 时间复杂度:$O(n\log n)$
- 空间复杂度:$O(n) $
- 稳定排序
- 非原地排序
非递归代码版本:
void mergeSort(vector<int>& arr) {
    int n = arr.length;
    // 子数组的大小分别为1,2,4,8...
    // 刚开始合并的数组大小是1,接着是2,接着4....
    for (int i = 1; i < n; i += i) {
        //进行数组进行划分
        int left = 0;
        int mid = left + i - 1;
        int right = mid + i;
        //进行合并,对数组大小为 i 的数组进行两两合并
        while (right < n) {
            // 合并函数和递归式的合并函数一样
            merge(arr, left, mid, right);
            left = right + 1;
            mid = left + i - 1;
            right = mid + i;
    }
        // 还有一些被遗漏的数组没合并,千万别忘了
        // 因为不可能每个字数组的大小都刚好为 i
        if (left < n && mid < n) {
            merge(arr, left, mid, n - 1);
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def merge_sort(nums):
    if len(nums) <= 1:
        return nums
    middle = len(nums) // 2
    left, right = merge_sort(nums[:middle]), merge_sort(nums[middle:])
    answer = []
    while left and right:
        answer.append((left if left[0] <= right[0] else right).pop(0))
    return answer + left + right
快速排序
快速排序是一种分而治之的算法,它选择一个基准值(pivot)并围绕它对数组进行分区,将小于基准值的元素移到其左侧,将大于基准值的元素移到其右侧。然后递归地对基准值左右两边的子数组进行相同的操作,直到整个数组排序完成。快速排序的平均时间复杂度为$O(nlogn)$,但在最坏情况下,时间复杂度可以退化到$O(n^2)$。
快速排序流程:
- 选择基准值:从数组中选择一个元素作为基准(pivot),通常选择数组的第一个元素或者最后一个元素。
- 分区操作:通过基准值,将数组分成两个部分,一部分包含所有小于基准值的元素,另一部分包含所有大于或等于基准值的元素。这一步确保了数组的一部分是有序的。
- 递归排序:对基准值左右两边的子数组分别进行快速排序,这一过程通过递归实现。
- 重复过程:重复步骤1到3,直到整个数组有序。
算法实现:
int partition(vector<int>& arr, int low, int high) {
    int pivot = arr[high]; // 选择最右侧的元素作为基准
    int i = (low - 1); // 小于基准的元素的索引
    for (int j = low; j <= high - 1; j++) {
        // 如果当前元素小于或等于基准
        if (arr[j] <= pivot) {
            i++; // 增加小于基准元素的索引
            swap(arr[i], arr[j]); // 交换元素
        }
    }
    swap(arr[i + 1], arr[high]); // 交换基准元素到正确的位置
    return (i + 1);
}
// 快速排序的主函数
void quickSort(vector<int>& arr, int low, int high) {
    if (low < high) {
        // pi是分区索引,arr[pi]现在位于正确的位置
        int pi = partition(arr, low, high);
        // 独立地对基准左侧和右侧的元素进行快速排序
        quickSort(arr, low, pi - 1);
        quickSort(arr, pi + 1, high);
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def quick_sort(nums, left=0, right=None):
    right = len(nums) - 1 if right is None else right
    if left >= right:
        return nums
    pivot, i, j = nums[(left + right) // 2], left, right
    while i <= j:
        while nums[i] < pivot: i += 1
        while nums[j] > pivot: j -= 1
        if i <= j:
            nums[i], nums[j] = nums[j], nums[i]
            i, j = i + 1, j - 1
    quick_sort(nums, left, j)
    quick_sort(nums, i, right)
    return nums
性质:
- 时间复杂度:平均为$O(n\log n)$,最坏为$O(n^2)$。
- 空间复杂度:$O(\log n)$,这是因为递归调用栈的深度为$O(\log n)$,每一层递归调用都需要一定的空间来存储局部变量和函数调用信息。
- 非稳定排序
- 原地排序
堆排序
堆排序是一种基于比较的排序算法,它利用了二叉堆(一种特殊的完全二叉树)的性质来进行排序。在最大堆中,每个节点的值都不小于其子节点的值;在最小堆中,每个节点的值都不大于其子节点的值。
堆排序流程:
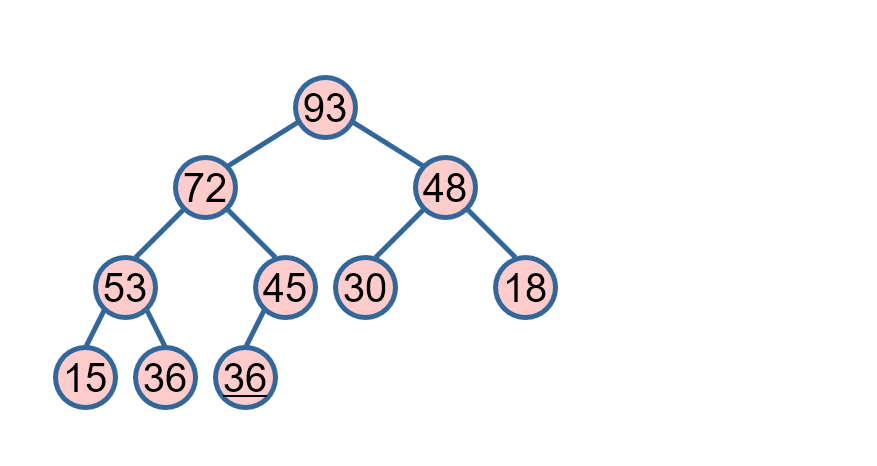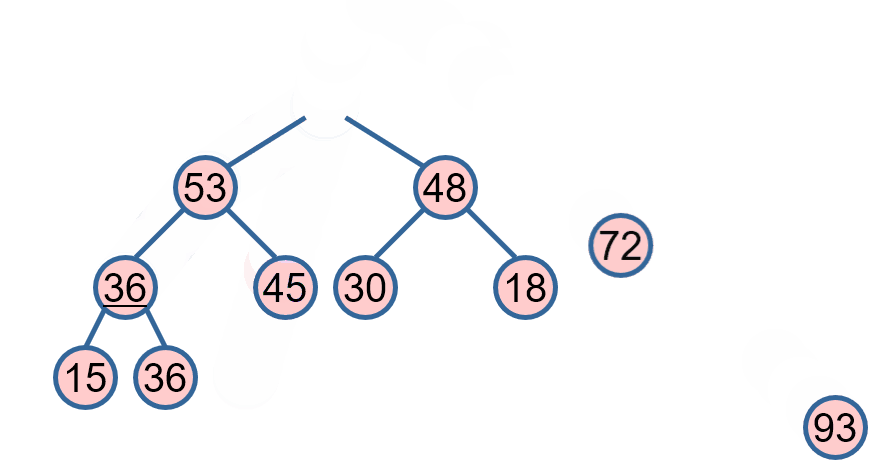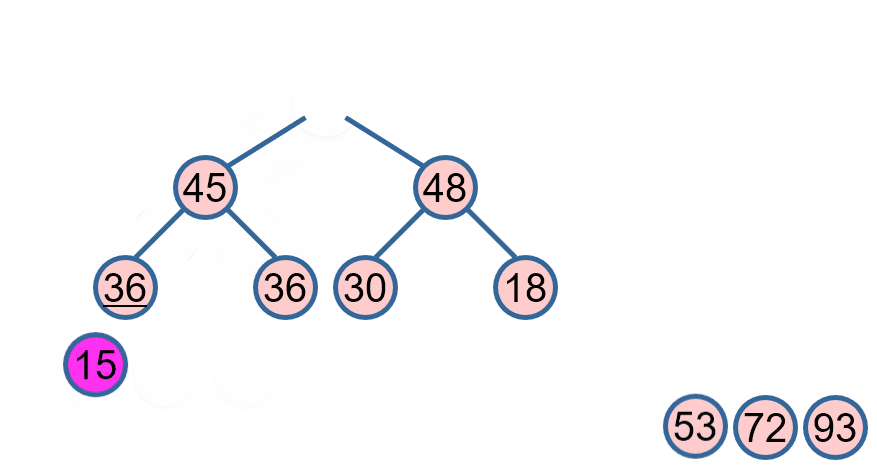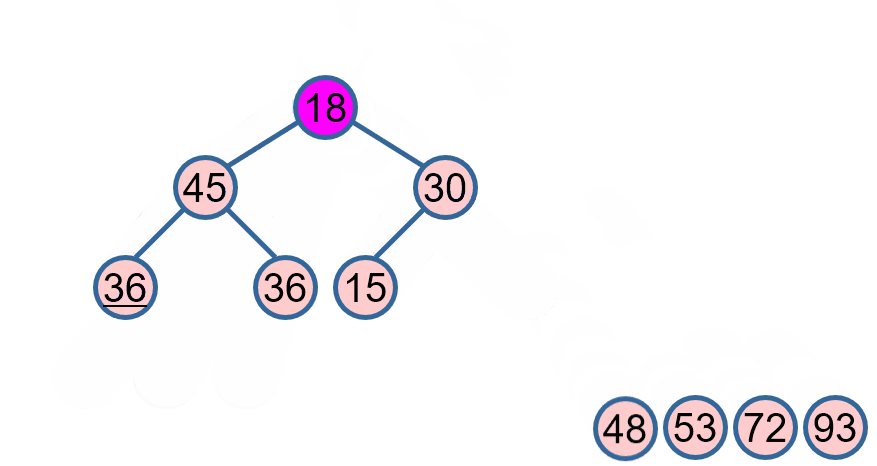
- 建堆:从最后一个非叶子节点(通常是最后一个元素的父节点)开始,自底向上、自右向左进行下沉调整,确保每个节点都满足堆的性质。最终整个序列成为一个大顶堆(或小顶堆)。
- 堆排序:将堆顶元素(最大或最小元素)与堆尾元素交换。堆长度减一,表示移除了已排序的最大(或最小)元素。然后重新对剩余元素进行下沉调整,恢复堆性质。重复上述步骤,直至堆长度为1,整个序列有序。
void heapify(vector<int>& arr, int n, int i) {
    int largest = i; // 初始化最大值为根节点
    int left = 2 * i + 1; // 左子节点
    int right = 2 * i + 2; // 右子节点
    // 如果左子节点大于根节点
    if (left < n && arr[left] > arr[largest])
        largest = left;
    // 如果右子节点大于目前的最大值
    if (right < n && arr[right] > arr[largest])
        largest = right;
    // 如果最大值不是根节点
    if (largest != i) {
        swap(arr[i], arr[largest]); // 交换根节点和最大值节点
        // 递归地对受影响的子树进行堆化
        heapify(arr, n, largest);
    }
}
// 堆排序的主函数
void heapSort(vector<int>& arr) {
    int n = arr.size();
    // 构建堆(重新排列数组)
    // n/2 --- n-1 都是叶子节点
    for (int i = n / 2 - 1; i >= 0; i--)
        heapify(arr, n, i);
    // 逐个提取元素
    for (int i = n - 1; i > 0; i--) {
        // 将当前根节点移到末尾
        swap(arr[0], arr[i]);
        // 调用heapify在减少的堆上
        heapify(arr, i, 0);
    }
}
最大堆排序是从小到大,最小堆是从大到小。 对应C++数据结构是priority_queue, 默认的是std::less比较,堆顶是最大的元素。
priority_queue 的使用
std::priority_queue 是 C++ 标准库提供的优先队列,底层容器默认使用 vector,内部通过堆维护最高优先级的元素。它的模板参数为:
std::priority_queue<T, Container, Compare>
T:元素类型;Container:底层容器,默认是std::vector<T>;Compare:比较规则,默认是std::less<T>,因此默认得到最大堆。
常用接口如下:
#include <functional>
#include <iostream>
#include <queue>
#include <vector>

std::priority_queue<int> maxHeap;

maxHeap.push(3);       // 插入元素
maxHeap.emplace(5);    // 直接在容器中构造元素
maxHeap.push(1);

std::cout << maxHeap.top() << '\n';  // 5,只读取堆顶
maxHeap.pop();                        // 删除堆顶,不返回元素
std::cout << maxHeap.top() << '\n';  // 3

std::cout << maxHeap.size() << '\n';
std::cout << maxHeap.empty() << '\n';
top() 获取堆顶的时间复杂度为 $O(1)$,push()、emplace() 和 pop() 的时间复杂度为 $O(\log n)$。pop() 没有返回值,所以需要先通过 top() 保存堆顶,再执行删除。
最大堆和最小堆
默认的 priority_queue<int> 是最大堆。如果需要最小堆,可以将比较器改为 std::greater<int>:
// 最大堆:堆顶是最大值
std::priority_queue<int> maxHeap;

// 最小堆:堆顶是最小值
std::priority_queue<int,
                    std::vector<int>,
                    std::greater<int>> minHeap;

for (int value : {5, 2, 8, 1}) {
    maxHeap.push(value);
    minHeap.push(value);
}

std::cout << maxHeap.top() << '\n';  // 8
std::cout << minHeap.top() << '\n';  // 1
也可以使用一段已有数据直接建堆。批量建堆通常比逐个插入更合适:
std::vector<int> nums{5, 2, 8, 1};
std::priority_queue<int> heap(nums.begin(), nums.end());
自定义比较器
存储自定义类型时,需要定义谁的优先级更高。比较器返回 true 表示左侧元素的优先级低于右侧元素。下面先按 priority 从大到小处理;优先级相同时,先处理 timestamp 更小的任务:
struct Task {
    int priority;
    int timestamp;
    int taskId;
};

struct TaskCompare {
    bool operator()(const Task& lhs, const Task& rhs) const {
        if (lhs.priority != rhs.priority) {
            return lhs.priority < rhs.priority;
        }
        return lhs.timestamp > rhs.timestamp;
    }
};

std::priority_queue<Task, std::vector<Task>, TaskCompare> tasks;

tasks.push({2, 100, 1});
tasks.push({3, 120, 2});
tasks.push({3, 110, 3});

Task next = tasks.top();
// next.taskId == 3:priority 最大,且 timestamp 更小
tasks.pop();
使用最小堆求最大的 K 个元素
遍历数据时只保留大小为 K 的最小堆。堆顶是当前 K 个最大元素中最小的一个;遇到更大的值时替换堆顶,空间复杂度为 $O(K)$,时间复杂度为 $O(n\log K)$。
std::vector<int> findKLargest(const std::vector<int>& nums, int k) {
    if (k <= 0) {
        return {};
    }

    std::priority_queue<int,
                        std::vector<int>,
                        std::greater<int>> heap;

    for (int value : nums) {
        if (static_cast<int>(heap.size()) < k) {
            heap.push(value);
        } else if (value > heap.top()) {
            heap.pop();
            heap.push(value);
        }
    }

    std::vector<int> result;
    while (!heap.empty()) {
        result.push_back(heap.top());
        heap.pop();
    }
    std::reverse(result.begin(), result.end());
    return result;
}
Python 实现
import heapq

def heap_sort(nums):
    heapq.heapify(nums)
    return [heapq.heappop(nums) for _ in range(len(nums))]
priority_queue 只保证堆顶元素具有最高优先级,并不保证底层所有元素整体有序;它也不提供迭代器、随机访问或直接修改堆中任意元素的接口。如果元素优先级发生变化,通常需要删除旧记录后重新插入,或者采用“新记录入堆、旧记录懒删除”的方式处理。
性质:
- 时间复杂度:最坏为$O(n\log n)$
- 空间复杂度:$O(1)$
- 非稳定排序
- 原地排序
计数排序
计数排序是一种线性时间排序算法,特别适合于处理具有一定范围的整数数组。它的工作原理是计算每个元素在数组中出现的次数,然后根据这些计数来确定元素在排序数组中的位置。计数排序不是比较排序,因此其时间复杂度为O(n)。
计数排序流程:
- 找出待排序的数组中最大和最小的元素。 2。 统计数组中每个值为 i 的元素出现的次数,存入数组 C 的第 i 项。
- 对所有的计数累加(从 C 中的第一个元素开始,每一项和前一项相加)。
- 反向填充目标数组:将每个元素 i 放在新数组的第 C(i) 项,每放一个元素就将 C(i) 减去1。
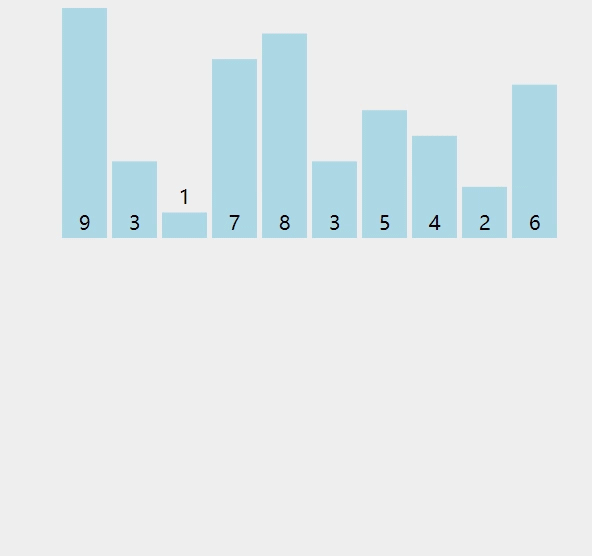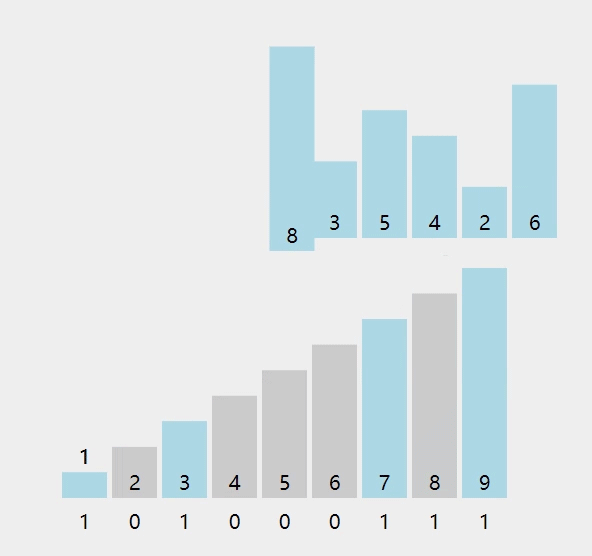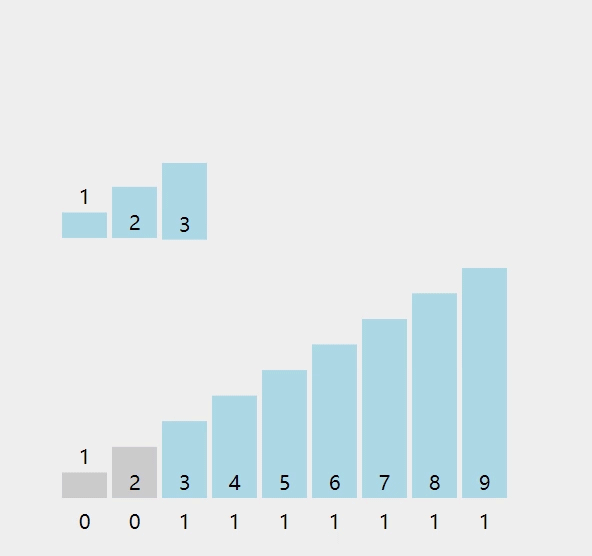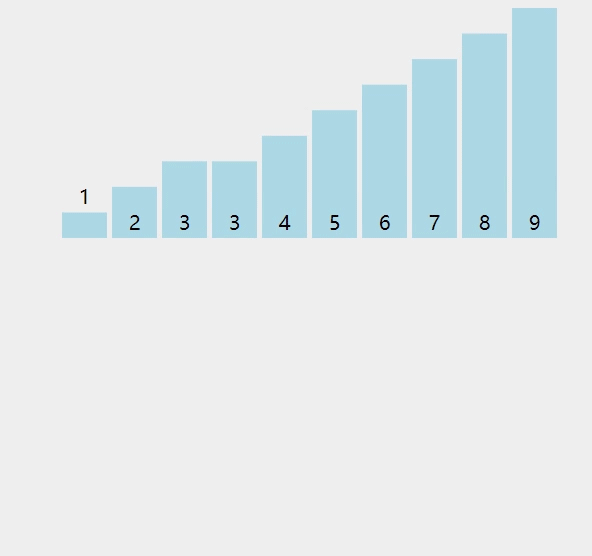
算法实现:
void countingSort(vector<int>& arr) {
    // 如果数组为空,则直接返回
    if (arr.empty())
        return;
    // 找到数组中的最大值以确定计数数组的大小
    int max_val = *std::max_element(arr.begin(), arr.end());
    // 初始化计数数组,并将所有元素设置为0
    vector<int> count(max_val + 1, 0);
    // 遍历数组,计算每个元素的出现次数
    for (int value : arr) {
        count[value]++;
    }
    // 修改计数数组,使其每个元素都包含小于或等于其索引值的元素数量
    for (size_t i = 1; i < count.size(); i++) {
        count[i] += count[i - 1];
    }
    // 创建输出数组
    vector<int> output(arr.size());
    // 构建输出数组
    for (int i = arr.size() - 1; i >= 0; i--) {
        output[--count[arr[i]]] = arr[i];
    }
    // 将输出数组复制回原数组
    arr = output;
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def counting_sort(nums):
    if not nums: return []
    low, high = min(nums), max(nums)
    count = [0] * (high - low + 1)
    for value in nums: count[value - low] += 1
    return [value for i, total in enumerate(count) for value in [i + low] * total]
性质:
- 时间复杂度:$O(n+k)$, $k$ = count.size().
- 空间复杂度:$O(k)$
- 稳定排序
- 非原地排序
桶排序
桶排序是一种分布式排序算法,它将元素分布到多个“桶”中,每个桶内部再分别进行排序(可以使用其他排序算法或递归地使用桶排序)。桶排序特别适合用于数据分布较均匀且可以均匀划分到各个桶中的情况。其平均时间复杂度为$O(n + k)$,其中 $n$ 是元素数量,$k$ 是桶的数量。
算法实现:
void bucketSort(vector<int>& arr) {
    // 如果数组为空,则直接返回
    if (arr.empty())
        return;
    // 找到数组中的最大值和最小值
    int max_val = *max_element(arr.begin(), arr.end());
    int min_val = *min_element(arr.begin(), arr.end());
    // 计算桶的数量
    int bucket_num = (max_val - min_val) / arr.size() + 1;
    // 创建桶
    vector<std::vector<int>> buckets(bucket_num);
    // 将元素分布到各个桶中
    for (int value : arr) {
        int bucket_index = (value - min_val) / arr.size();
        buckets[bucket_index].push_back(value);
    }
    // 对每个桶进行排序,并将结果收集到原数组中
    int index = 0;
    for (auto& bucket : buckets) {
        sort(bucket.begin(), bucket.end()); // 可以使用其他排序算法或递归调用桶排序
        for (int value : bucket) {
            arr[index++] = value;
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def bucket_sort(nums, bucket_size=10):
    if not nums: return []
    low = min(nums)
    buckets = [[] for _ in range((max(nums) - low) // bucket_size + 1)]
    for value in nums: buckets[(value - low) // bucket_size].append(value)
    return [value for bucket in buckets for value in sorted(bucket)]
性质:
- 时间复杂度:$O(n+k)$, $k$ = count.size().
- 空间复杂度:$O(k)$
- 稳定排序
- 非原地排序
基数排序
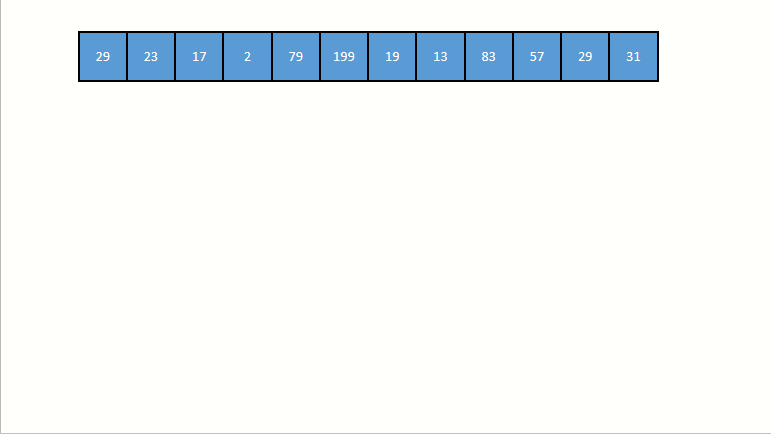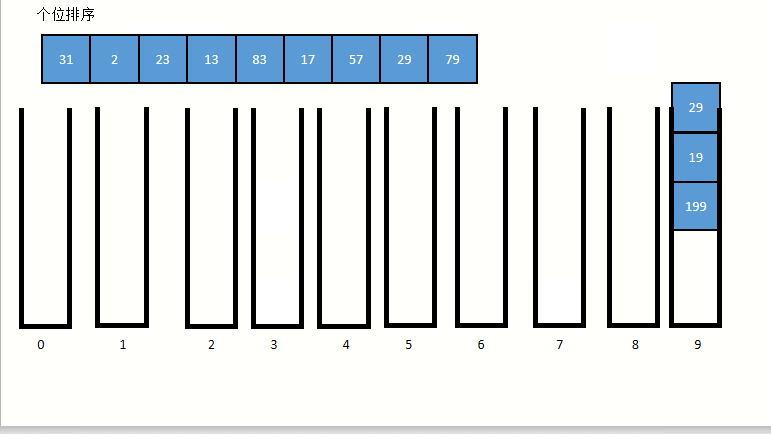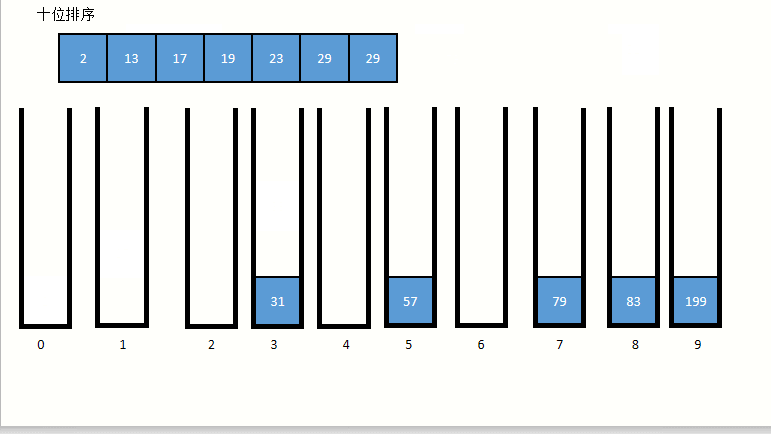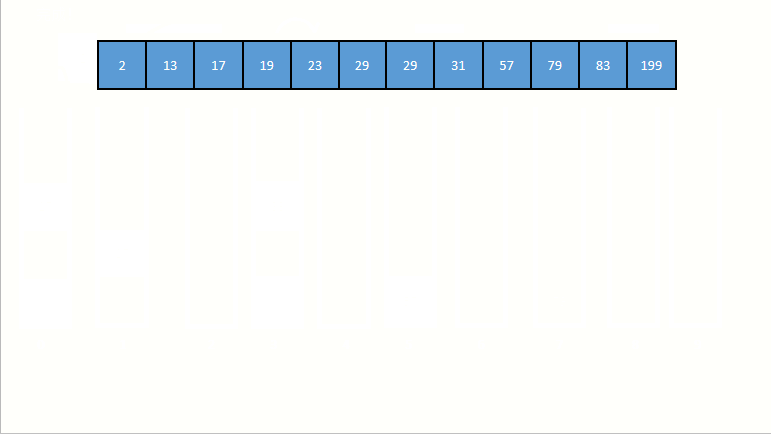
基数排序是一种非比较型整数排序算法,它按照数字的每一位(或字符)来进行排序。基数排序的基本思想是将所有元素按照某个位上的数字进行排序,接着按照更高位进行排序,依此类推,直到最低位。 它智能处理全为正数的情况,对于正负数混合的数组,需要先分为两组再进行基数排序。
基数排序流程:
- 确定最大位数:首先找出待排序数组中的最大数的位数,以确定需要按多少位进行排序。
- 按位分配:从最低位开始,根据该位的值将数组中的元素分配到不同的“桶”中。
- 收集元素:将各个桶中的元素按照顺序合并回原数组,此时数组已经按照最低有效位进行了排序。
- 重复排序过程:对次低有效位、第三位有效位…直到最高有效位重复进行排序和合并的过程。
- 获得最终结果:当最高有效位排序完成后,数组中的所有元素已经按照从最低位到最高位的顺序排好序。
int getMaxDigit(const std::vector<int>& arr) {
    int max_val = *std::max_element(arr.begin(), arr.end());
    int digit = 0;
    while (max_val > 0) {
        max_val /= 10;
        digit++;
    }
    return digit;
}
// 基数排序函数
void radixSort(std::vector<int>& arr) {
    int max_digit = getMaxDigit(arr);
    int mod = 10;
    int dev = 1;
    vector<vector<int>> counter(10); // 因为我们有十个数字(0-9)
    for (int i = 0; i < max_digit; i++, dev *= 10, mod *= 10) {
        // 清空计数器
        for (auto& bucket : counter) {
            bucket.clear();
        }
        // 根据当前位数将元素分配到计数器中
        for (int value : arr) {
            int bucket_index = (value % mod) / dev;
            counter[bucket_index].push_back(value);
        }
        // 将计数器中的元素收集回原数组
        int index = 0;
        for (auto& bucket : counter) {
            for (int value : bucket) {
                arr[index++] = value;
            }
        }
    }
}
Python 实现
# 本题仅使用 Python 内置功能,无需额外 import。
def radix_sort_nonnegative(nums):
    exponent = 1
    while nums and max(nums) // exponent:
        buckets = [[] for _ in range(10)]
        for value in nums: buckets[value // exponent % 10].append(value)
        nums[:] = [value for bucket in buckets for value in bucket]
        exponent *= 10
    return nums
std::sort 使用的是Introsort(内省排序)算法,这是一种混合排序算法。它结合了快速排序、堆排序和插入排序的优点,能够在大多数情况下提供高效的排序性能,并且可以避免快速排序最坏情况下的性能问题。
Introsort 的工作原理
Introsort 会根据递归深度和数组大小选择不同的排序方法:
-
快速排序:在排序开始时,
std::sort使用快速排序,因其平均时间复杂度为 ( O(n \log n) ) 且性能通常很好。 -
堆排序:当递归深度超过一定阈值时,快速排序可能会退化为最坏情况下的 ( O(n^2) ) 复杂度。为了防止这种情况,
std::sort会切换到堆排序,堆排序的时间复杂度是 ( O(n \log n) )。 -
插入排序:当数组分区的大小变得很小(通常是16个元素或更少)时,
std::sort会使用插入排序。插入排序在小规模数组上性能很好,因为其额外的比较和移动操作开销较低。
复杂度
- 平均时间复杂度:( O(n \log n) )
- 最坏时间复杂度:( O(n \log n) )(通过切换到堆排序来避免 ( O(n^2) ) 的情况)
为什么选择 Introsort?
Introsort 结合了三种排序算法的优点,避免了单一排序算法在某些情况下的低效表现。快速排序适用于大部分情况,堆排序保证了最坏情况下的性能,插入排序则适合小规模数组。
Python 实现
import heapq
import math

def introsort(nums):
    def insertion(left, right):
        for i in range(left + 1, right + 1):
            value, j = nums[i], i - 1
            while j >= left and nums[j] > value:
                nums[j + 1] = nums[j]
                j -= 1
            nums[j + 1] = value

    def heap_sort(left, right):
        heap = nums[left:right + 1]
        heapq.heapify(heap)
        for i in range(left, right + 1):
            nums[i] = heapq.heappop(heap)

    def sort(left, right, depth):
        if right - left + 1 <= 16:
            insertion(left, right)
            return
        if depth == 0:
            heap_sort(left, right)
            return
        pivot, i, j = nums[(left + right) // 2], left, right
        while i <= j:
            while nums[i] < pivot: i += 1
            while nums[j] > pivot: j -= 1
            if i <= j:
                nums[i], nums[j] = nums[j], nums[i]
                i, j = i + 1, j - 1
        if left < j: sort(left, j, depth - 1)
        if i < right: sort(i, right, depth - 1)

    if nums:
        sort(0, len(nums) - 1, 2 * math.floor(math.log2(len(nums))))
    return nums
双堆和 deque 结合求滑动窗口中位数
为了实现实时插入 (time, value) 对并计算10分钟内价格的中位数,可以使用以下方法:
- 使用一个滑动窗口数据结构来保存10分钟内的价格。
- 使用双端队列来存储滑动窗口内的元素,这样我们可以轻松地在时间过期时移除旧数据。
- 使用两个堆(最大堆和最小堆)来保持滑动窗口的中位数,这样插入和删除操作的效率较高。
代码实现
#include <queue>
#include <deque>
#include <vector>
#include <utility>
#include <iostream>

class StockPriceMedian {
private:
    std::deque<std::pair<int, int>> window; // 滑动窗口存储(time, value)
    std::priority_queue<int> maxHeap; // 最大堆,存储左半部分
    std::priority_queue<int, std::vector<int>, std::greater<int>> minHeap; // 最小堆,存储右半部分

    // 平衡两个堆,保证最大堆的大小始终 >= 最小堆的大小
    void balanceHeaps() {
        if (maxHeap.size() > minHeap.size() + 1) {
            minHeap.push(maxHeap.top());
            maxHeap.pop();
        } else if (minHeap.size() > maxHeap.size()) {
            maxHeap.push(minHeap.top());
            minHeap.pop();
        }
    }

    // 插入新值到两个堆中
    void insertPrice(int price) {
        if (maxHeap.empty() || price <= maxHeap.top()) {
            maxHeap.push(price);
        } else {
            minHeap.push(price);
        }
        balanceHeaps();
    }

    // 从堆中删除指定值
    void removePrice(int price) {
        // 标记为懒删除,等到堆顶出现过期元素时移除
        if (!maxHeap.empty() && price <= maxHeap.top()) {
            // 将最大堆中的元素移除
            maxHeap.pop();
        } else {
            // 将最小堆中的元素移除
            minHeap.pop();
        }
        balanceHeaps();
    }

public:
    double insert(int time, int price) {
        // 插入新数据
        window.push_back({time, price});
        insertPrice(price);

        // 移除超过10分钟的数据
        while (!window.empty() && window.front().first <= time - 600) {
            removePrice(window.front().second);
            window.pop_front();
        }

        // 计算中位数
        if (maxHeap.size() == minHeap.size()) {
            return (maxHeap.top() + minHeap.top()) / 2.0;
        } else {
            return maxHeap.top();
        }
    }
};
代码解析
window:一个双端队列,用于存储滑动窗口中的(time, price)对,方便在时间超出10分钟时移除旧数据。- 最大堆和最小堆:用于维护滑动窗口的中位数,最大堆保存左半部分的元素,最小堆保存右半部分的元素。
balanceHeaps():保持两个堆的平衡,使得最大堆的大小始终大于或等于最小堆。insertPrice和removePrice:分别用于向堆中插入和移除价格。insert方法:在插入新的(time, price)对后,自动维护10分钟内价格的中位数,返回当前窗口的中位数。
时间复杂度
- 插入和删除的复杂度:由于堆的插入和删除的复杂度为 ( O(\log n) )。
- 返回中位数的复杂度为 ( O(1) ),因为堆顶元素可直接获取。
更简洁的实现:deque + 两个 multiset
上面的双堆代码保留了基本思路,但 priority_queue 只能删除堆顶。原实现中的 removePrice() 直接执行 pop(),只有当过期价格正好位于相应堆顶时才正确;完整的双堆方案还需要使用哈希表记录待删除元素,并在它们到达堆顶时执行懒删除。
如果优先考虑实现简洁和正确性,可以将两个堆换成两个 multiset:
lower保存较小的一半,最大元素为*lower.rbegin();upper保存较大的一半,最小元素为*upper.begin();- 保持
lower.size() == upper.size()或lower.size() == upper.size() + 1; multiset支持在 $O(\log n)$ 时间内查找并删除任意一个过期价格,重复价格也可以正确处理。
#include <deque>
#include <iterator>
#include <set>
#include <utility>

class StockPriceMedianMultiset {
public:
    double insert(int time, int price) {
        window.push_back({time, price});
        insertPrice(price);

        while (!window.empty() && window.front().first <= time - 600) {
            erasePrice(window.front().second);
            window.pop_front();
        }

        return median();
    }

private:
    void insertPrice(int price) {
        if (lower.empty() || price <= *lower.rbegin()) {
            lower.insert(price);
        } else {
            upper.insert(price);
        }
        rebalance();
    }

    void erasePrice(int price) {
        auto lowerIt = lower.find(price);
        if (lowerIt != lower.end()) {
            lower.erase(lowerIt);
        } else {
            auto upperIt = upper.find(price);
            if (upperIt != upper.end()) {
                upper.erase(upperIt);
            }
        }
        rebalance();
    }

    void rebalance() {
        while (lower.size() > upper.size() + 1) {
            auto it = std::prev(lower.end());
            upper.insert(*it);
            lower.erase(it);
        }

        while (lower.size() < upper.size()) {
            auto it = upper.begin();
            lower.insert(*it);
            upper.erase(it);
        }
    }

    double median() const {
        if (lower.size() == upper.size()) {
            return (static_cast<double>(*lower.rbegin()) +
                    static_cast<double>(*upper.begin())) / 2.0;
        }
        return static_cast<double>(*lower.rbegin());
    }

    std::deque<std::pair<int, int>> window;
    std::multiset<int> lower;
    std::multiset<int> upper;
};
Python 实现:deque + 双堆 + 延迟删除
这里的窗口由时间决定,而不是固定元素个数。insert(time, value) 假设时间戳按非递减顺序到达,并保留区间 (time - 600, time] 内的价格;median() 单独返回当前窗口的中位数。
Python 的 heapq 不能直接删除堆中任意位置的过期价格,所以用 delayed 记录待删除的值;只有当它们移动到堆顶时,才真正从堆中弹出。lower_size 和 upper_size 记录排除过期元素后的有效数量。
from collections import Counter, deque
import heapq


class StockPriceMedian:
    WINDOW_SECONDS = 600

    def __init__(self):
        self.window = deque()     # (time, value)
        self.lower = []           # 最大堆,用负数模拟
        self.upper = []           # 最小堆
        self.delayed = Counter()  # 尚未从堆顶弹出的过期值
        self.lower_size = 0       # lower 中的有效元素数
        self.upper_size = 0       # upper 中的有效元素数

    def insert(self, time, value):
        """插入一条记录,窗口保留 (time - 600, time] 内的数据。"""
        if self.window and time < self.window[-1][0]:
            raise ValueError("time 必须按非递减顺序插入")

        self.window.append((time, value))
        self._add(value)

        cutoff = time - self.WINDOW_SECONDS
        while self.window and self.window[0][0] <= cutoff:
            _, expired_value = self.window.popleft()
            self._remove(expired_value)

    def median(self):
        """返回相对于最新时间戳的十分钟窗口中位数。"""
        if self.lower_size + self.upper_size == 0:
            raise ValueError("窗口中没有数据")

        self._prune(self.lower, is_lower=True)
        self._prune(self.upper, is_lower=False)
        if self.lower_size == self.upper_size:
            return (-self.lower[0] + self.upper[0]) / 2.0
        return float(-self.lower[0])

    def _add(self, value):
        self._prune(self.lower, is_lower=True)
        if not self.lower or value <= -self.lower[0]:
            heapq.heappush(self.lower, -value)
            self.lower_size += 1
        else:
            heapq.heappush(self.upper, value)
            self.upper_size += 1
        self._rebalance()

    def _remove(self, value):
        self._prune(self.lower, is_lower=True)
        self._prune(self.upper, is_lower=False)
        self.delayed[value] += 1

        if value <= -self.lower[0]:
            self.lower_size -= 1
        else:
            self.upper_size -= 1
        self._rebalance()

    def _rebalance(self):
        self._prune(self.lower, is_lower=True)
        self._prune(self.upper, is_lower=False)

        while self.lower_size > self.upper_size + 1:
            heapq.heappush(self.upper, -heapq.heappop(self.lower))
            self.lower_size -= 1
            self.upper_size += 1
            self._prune(self.lower, is_lower=True)

        while self.lower_size < self.upper_size:
            heapq.heappush(self.lower, -heapq.heappop(self.upper))
            self.lower_size += 1
            self.upper_size -= 1
            self._prune(self.upper, is_lower=False)

    def _prune(self, heap, is_lower):
        while heap:
            value = -heap[0] if is_lower else heap[0]
            if self.delayed[value] == 0:
                break

            heapq.heappop(heap)
            self.delayed[value] -= 1
            if self.delayed[value] == 0:
                del self.delayed[value]


prices = StockPriceMedian()
prices.insert(0, 10)
prices.insert(100, 20)
print(prices.median())  # 15.0

prices.insert(601, 30)  # time=0 的价格已过期
print(prices.median())  # 25.0
每个价格只会进入和离开有效窗口一次。单条数据的堆插入、标记删除和再平衡均为均摊 $O(\log n)$,median() 为 $O(1)$;一次 insert() 若同时清理 $m$ 条过期记录,则该次调用为 $O((m+1)\log n)$。
归并排序和快速排序的并行化
归并排序和快速排序都使用分治算法。一次划分结束后,左右子区间之间不再相互依赖,因此可以交给不同线程并行处理。这里使用 OpenMP task,而不是在每一层递归中直接创建 std::thread:OpenMP 线程池负责执行任务,同时通过 cutoff 控制任务粒度,避免为很小的区间创建大量任务。
编译时需要启用 OpenMP:
g++ -O3 -std=c++17 -fopenmp parallel_sort.cpp
并行归并排序
归并排序可以先并行排序左右两半,等待两个任务都完成后,再合并两个有序区间。左右任务访问互不重叠的数组范围;taskwait 保证合并开始时,两边都已经有序。
#include <algorithm>
#include <vector>

void mergeRange(std::vector<int>& nums,
                std::vector<int>& buffer,
                int left,
                int mid,
                int right) {
    int i = left;
    int j = mid + 1;
    int k = left;

    while (i <= mid && j <= right) {
        if (nums[i] <= nums[j]) {
            buffer[k++] = nums[i++];
        } else {
            buffer[k++] = nums[j++];
        }
    }
    while (i <= mid) {
        buffer[k++] = nums[i++];
    }
    while (j <= right) {
        buffer[k++] = nums[j++];
    }
    std::copy(buffer.begin() + left,
              buffer.begin() + right + 1,
              nums.begin() + left);
}

void parallelMergeSortImpl(std::vector<int>& nums,
                           std::vector<int>& buffer,
                           int left,
                           int right,
                           int cutoff) {
    if (left >= right) {
        return;
    }

    if (right - left + 1 <= cutoff) {
        std::stable_sort(nums.begin() + left, nums.begin() + right + 1);
        return;
    }

    int mid = left + (right - left) / 2;

    #pragma omp task shared(nums, buffer) firstprivate(left, mid, cutoff)
    parallelMergeSortImpl(nums, buffer, left, mid, cutoff);

    #pragma omp task shared(nums, buffer) firstprivate(mid, right, cutoff)
    parallelMergeSortImpl(nums, buffer, mid + 1, right, cutoff);

    #pragma omp taskwait
    mergeRange(nums, buffer, left, mid, right);
}

void parallelMergeSort(std::vector<int>& nums, int cutoff = 1 << 14) {
    if (nums.size() < 2) {
        return;
    }

    std::vector<int> buffer(nums.size());

    #pragma omp parallel
    {
        #pragma omp single nowait
        parallelMergeSortImpl(nums, buffer, 0,
                              static_cast<int>(nums.size()) - 1,
                              cutoff);
    }
}
并行部分主要发生在递归排序阶段。上面的 mergeRange 仍然是串行合并,因此数据规模较大时,顶层合并会限制加速比;若继续优化,可以将两个有序区间通过二分查找拆成多个互不重叠的输出区间,再并行合并。
并行快速排序
快速排序先完成 partition,再并行处理基准值左右两侧。下面使用三路划分,将数组分成 < pivot、== pivot 和 > pivot 三段,可以避免大量重复元素不断进入下一层递归。基准值采用首、中、尾元素的中位数,降低已经有序或接近有序数据产生极端不平衡划分的概率。
#include <algorithm>
#include <utility>
#include <vector>

int medianOfThree(int a, int b, int c) {
    if (a > b) {
        std::swap(a, b);
    }
    if (b > c) {
        std::swap(b, c);
    }
    if (a > b) {
        std::swap(a, b);
    }
    return b;
}

std::pair<int, int> partitionThreeWay(std::vector<int>& nums,
                                      int left,
                                      int right) {
    int mid = left + (right - left) / 2;
    int pivot = medianOfThree(nums[left], nums[mid], nums[right]);

    int less = left;
    int current = left;
    int greater = right;

    while (current <= greater) {
        if (nums[current] < pivot) {
            std::swap(nums[less++], nums[current++]);
        } else if (nums[current] > pivot) {
            std::swap(nums[current], nums[greater--]);
        } else {
            ++current;
        }
    }
    return {less, greater};
}

void parallelQuickSortImpl(std::vector<int>& nums,
                           int left,
                           int right,
                           int cutoff) {
    if (left >= right) {
        return;
    }

    if (right - left + 1 <= cutoff) {
        std::sort(nums.begin() + left, nums.begin() + right + 1);
        return;
    }

    auto [equalBegin, equalEnd] = partitionThreeWay(nums, left, right);

    #pragma omp task shared(nums) firstprivate(left, equalBegin, cutoff)
    parallelQuickSortImpl(nums, left, equalBegin - 1, cutoff);

    #pragma omp task shared(nums) firstprivate(equalEnd, right, cutoff)
    parallelQuickSortImpl(nums, equalEnd + 1, right, cutoff);

    #pragma omp taskwait
}

void parallelQuickSort(std::vector<int>& nums, int cutoff = 1 << 14) {
    if (nums.size() < 2) {
        return;
    }

    #pragma omp parallel
    {
        #pragma omp single nowait
        parallelQuickSortImpl(nums, 0,
                              static_cast<int>(nums.size()) - 1,
                              cutoff);
    }
}
Python 实现
from concurrent.futures import ProcessPoolExecutor

def parallel_sort(chunks):
    with ProcessPoolExecutor() as pool:
        sorted_chunks = list(pool.map(sorted, chunks))
    import heapq
    return list(heapq.merge(*sorted_chunks))
快速排序的并行效率取决于划分是否均衡。如果一次 partition 将绝大多数元素都分到同一边,另一侧线程很快就会空闲,递归深度也可能接近 $O(n)$。三路划分能改善重复元素场景,但不能从理论上消除最坏情况;工程实现通常还会限制最大递归深度,并在退化时切换到堆排序,这也是 Introsort 的基本思路。
并行化时需要注意的问题
- 不能无限创建任务:小区间直接串行排序,
cutoff应根据数据规模、核数和机器实测调整。 - 只并行无依赖的区间:归并排序必须先
taskwait再合并;快速排序必须先完成 partition,才能并行处理左右两侧。 - 避免共享写冲突:并行任务只能修改互不重叠的区间。归并排序的临时数组只分配一次,但每个任务写入的也是各自对应的下标范围。
- 并行不一定更快:小数组上任务调度和同步成本可能超过排序本身,应同时测量单线程基线、加速比和并行效率。
- 控制线程数:线程数量由 OpenMP 线程池控制,例如通过
OMP_NUM_THREADS=8设置;不能将递归任务数误认为实际线程数。