PyTorch 深度学习计算与工程实践:从 nn.Module 到可复现建模流程
Table of contents
- 本篇逻辑主线
- D2L
chapter_deep-learning-computation在本篇的位置 - 1.
nn.Module:层、块和模型是同一种抽象 - 2. 参数访问、注册和共享
- 3. 初始化:尺度与对称性都要处理
- 4. 延后初始化:先推断 shape,再创建真实参数
- 5. 自定义层:让参数留在计算图里
- 6. 读写文件:区分张量、模型权重和训练现场
- 7. Device 与 GPU:模型和数据必须在同一设备
- 8. 房价预测:表格数据的完整流程
- 9. 环境隔离、版本与 Jupyter kernel
- 10. 分布偏移与 AutoML 的正确位置
- 11. 让代码和知识长期可用
- 本篇知识链总结
- 常见误区
- 系列导航
- 对应章节与参考资料
本篇逻辑主线
会写一个 Linear 层并不等于拥有可维护的模型。D2L 的“深度学习计算”正是从“会调用层”走向“能组织、检查、保存和迁移模型”的桥梁:PyTorch 用 nn.Module 把层、参数和子块组织成树,Sequential 负责简单串联,自定义 forward 负责分支、复用和控制流;接着需要理解参数注册与共享、初始化与延后初始化、自定义层、序列化,以及 CPU/GPU 设备管理。模型外部还需要同样严格的数据流程:预处理规则只能在训练集上拟合,验证集负责选择方案,环境与随机性必须记录,checkpoint 要能恢复。房价预测提供了一条完整范例——从 pandas 表格、缺失值、标准化和 one-hot,走到 K 折、重训、保存和部署——也揭示了版本、dtype、高基数类别与分布偏移这些“代码之外”的工程约束。
D2L chapter_deep-learning-computation 在本篇的位置
这一章不发明新模型,而是解释后续所有复杂网络赖以成立的计算与工程抽象。下表与本地 Notebook 一一对应:
| D2L Notebook | 核心问题 | 本篇对应内容 |
|---|---|---|
model-construction |
层怎样递归组合成块和完整模型? | nn.Module、Sequential、ModuleList、控制流 |
parameters |
参数怎样访问、初始化和共享? | Parameter、buffer、state_dict、参数树 |
deferred-init |
输入维度未知时怎样确定参数 shape? | LazyLinear、首次 dry run |
custom-layer |
怎样实现框架没有提供的层? | 无参数层、带参数层、autograd 边界 |
read-write |
怎样保存张量、模型权重和训练现场? | torch.save、torch.load、checkpoint |
use-gpu |
数据与模型怎样迁移到加速设备? | device、一致性、传输成本 |
下面的代码默认已经导入:
import torch
from torch import nn
from torch.nn import functional as F
1. nn.Module:层、块和模型是同一种抽象
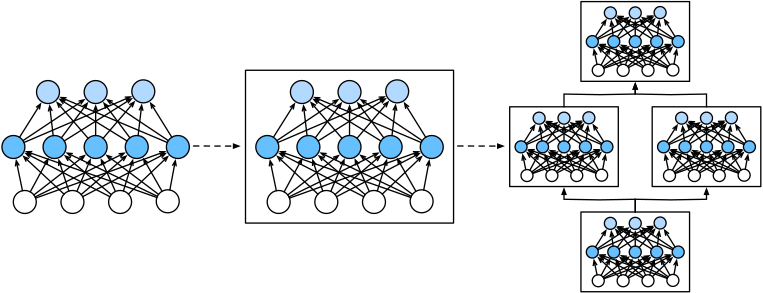
在 PyTorch 中,单层、残差块和完整网络都可以是 nn.Module。一个模块至少负责:
- 保存子模块和需要学习的
Parameter; - 定义从输入到输出的
forward; - 递归暴露参数、状态和设备迁移能力;
- 配合 autograd 自动完成反向传播。
这是一种递归抽象:层组成块,块再组成更大的块,直到成为完整模型。后面的 Inception block、Residual block 和 Dense block 都建立在同一个机制上。
class MLP(nn.Module):
    def __init__(self, in_features, hidden, out_features):
        super().__init__()
        self.hidden = nn.Linear(in_features, hidden)
        self.output = nn.Linear(hidden, out_features)

    def forward(self, X):
        X = torch.relu(self.hidden(X))
        return self.output(X)
通过 self.hidden = ... 赋值后,子层会被注册。若把层放在普通 Python list 里,PyTorch 不一定能发现它们;动态层列表应使用 nn.ModuleList,键值结构使用 nn.ModuleDict。
Sequential 与自定义 forward
纯串行结构适合:
net = nn.Sequential(
    nn.Linear(20, 64), nn.ReLU(),
    nn.Linear(64, 10),
)
若有多分支、跳跃连接、同一层复用或输入相关控制流,应写自定义模块。调用 net(X) 而不是直接 net.forward(X),因为 Module.__call__ 还负责 hooks、autocast 等框架逻辑。
torch.nn.functional.relu(X)(常写作 F.relu)是无状态函数,适合在自定义 forward 中临时调用;nn.ReLU() 是可注册进 Sequential 的模块。对 ReLU 这种无参数运算二者数学上相同,但模块形式更便于打印结构、挂 hook 和统一配置;带可学习参数或持久状态的层应使用模块并在 __init__ 中注册。
ModuleList、分支与控制流
Sequential 自带固定的串行 forward;ModuleList 只负责正确注册一组子模块,具体怎样运行仍由我们编写。因此,层数可配置或需要循环时应这样写:
class RepeatedMLP(nn.Module):
    def __init__(self, width, depth):
        super().__init__()
        self.layers = nn.ModuleList(
            [nn.Linear(width, width) for _ in range(depth)]
        )

    def forward(self, X):              # X: [batch, width]
        for layer in self.layers:
            X = F.relu(layer(X))
        return X                       # [batch, width]
普通 Python list 能参与循环,却不会像 ModuleList 一样把其中的层注册进模型;结果是 parameters()、state_dict()、.to(device) 都可能漏掉它们。自定义 forward 也可以包含分支、循环和普通张量运算,这正是 PyTorch eager execution 的灵活性;但输入相关的复杂 Python 控制流会给编译、导出和跨平台部署增加约束,应把“研究时的灵活”与“部署时的可导出”分开考虑。
2. 参数访问、注册和共享
for name, param in net.named_parameters():
    print(name, param.shape, param.requires_grad)

state = net.state_dict()
模型可以看成一棵命名树。named_modules() 查看结构,named_parameters() 递归返回需要优化的参数,named_buffers() 返回随模型保存和迁移、但不由优化器更新的状态;state_dict() 则把持久参数与 buffer 汇总为扁平键名,例如 encoder.0.weight。
| 对象 | 是否训练 | 是否出现在 parameters() |
是否进入 state_dict() |
是否随 .to(device) 迁移 |
|---|---|---|---|---|
nn.Parameter |
是 | 是 | 是 | 是 |
| 持久 buffer | 否 | 否 | 是 | 是 |
| 注册的子模块 | 取决于其参数 | 递归收集 | 递归收集 | 是 |
| 普通 tensor 属性 | 否 | 否 | 否 | 否 |
普通 tensor 属性不会自动成为参数或 buffer:
self.weight = nn.Parameter(torch.randn(in_dim, out_dim))
self.register_buffer("running_scale", torch.ones(out_dim))
调试嵌套模型时,不必手工逐层索引:
for name, module in net.named_modules():
    print(name, module.__class__.__name__)

for name, param in net.named_parameters():
    print(name, tuple(param.shape), param.requires_grad)
共享参数必须复用同一个层对象,而不是复制相同数值:
shared = nn.Linear(8, 8)
net = nn.Sequential(
    nn.Linear(4, 8), nn.ReLU(),
    shared, nn.ReLU(),
    shared, nn.ReLU(),
)
两个位置引用同一个参数,因此反向传播得到的梯度贡献会累加到同一 .grad。
assert net[2].weight is net[4].weight
“初始值相同”与“共享同一个参数对象”完全不同:前者训练一步后就可能分开,后者始终只有一份权重,并接收所有使用位置的梯度之和。
3. 初始化:尺度与对称性都要处理
PyTorch 层有合理默认初始化,但深层网络常需根据激活函数显式选择 Xavier 或 Kaiming:
def init_weights(m):
    if isinstance(m, nn.Linear):
        nn.init.kaiming_uniform_(m.weight, nonlinearity="relu")
        if m.bias is not None:
            nn.init.zeros_(m.bias)

net.apply(init_weights)
不能把同一层所有神经元的权重初始化为相同值。即使它不是 0,对称神经元也会收到相同梯度,始终学到相同特征。偏置初始化为 0 通常没有这个问题,因为随机权重已经打破对称。
4. 延后初始化:先推断 shape,再创建真实参数
有时构建模型时还不知道输入维度。nn.LazyLinear(out_features) 和 nn.LazyConv2d 会在第一次看到输入时推断缺失 shape:
net = nn.Sequential(nn.LazyLinear(64), nn.ReLU(), nn.Linear(64, 10))
net = net.to("cpu")                    # 先确定 device 和 dtype
net(torch.randn(2, 20))                # dry run
print(net[0].weight.shape)              # torch.Size([64, 20])
第一次前向前,权重还是 UninitializedParameter,不能可靠地读取 shape 或数值。稳妥顺序是:构建网络 → 设置 device/dtype → 用真实 shape 的样例做 dry run → 自定义初始化和 shape 审计 → 创建优化器。延后初始化减少硬编码,却不能替代 shape 检查;若后续输入的特征维与首次 dry run 不同,已经物化的线性层仍会报 shape 错误。
5. 自定义层:让参数留在计算图里
不带参数的中心化层:
class CenteredLayer(nn.Module):
    def forward(self, X):
        return X - X.mean()
带参数的自定义线性层:
class MyLinear(nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.weight = nn.Parameter(torch.empty(out_features, in_features))
        self.bias = nn.Parameter(torch.zeros(out_features))
        nn.init.kaiming_uniform_(self.weight, nonlinearity="relu")

    def forward(self, X):
        return torch.relu(X @ self.weight.T + self.bias)
前向传播中不要使用 self.weight.data,否则运算可能绕开 autograd。只有明确不参与梯度的状态才注册为 buffer 或普通常量。
本地 D2L 旧 Notebook 的 MyLinear.forward 使用了 self.weight.data 和 self.bias.data。它适合展示底层数值,却不应作为当前训练代码照搬;正确实现应直接使用 Parameter,如上面的 X @ self.weight.T + self.bias。这样输出的计算图才会连接到参数,loss.backward() 后 weight.grad 才有意义。
6. 读写文件:区分张量、模型权重和训练现场
torch.save 能保存单个张量、列表或字典,torch.load 将其读回:
payload = {
    "mean": torch.zeros(4),
    "std": torch.ones(4),
}
torch.save(payload, "statistics.pt")
restored = torch.load("statistics.pt", weights_only=True)
对于模型,优先保存 state_dict。它包含参数和持久 buffer,但不包含定义 forward 的 Python 类代码,所以恢复时要先重建相同架构:
推荐保存模型与优化器状态,而不是依赖任意 Python 对象的整体序列化:
torch.save({
    "model": model.state_dict(),
    "optimizer": optimizer.state_dict(),
    "epoch": epoch,
    "config": config,
}, "checkpoint.pt")
恢复时先用代码重建相同架构,再加载:
checkpoint = torch.load("checkpoint.pt", map_location="cpu", weights_only=True)
model.load_state_dict(checkpoint["model"])
optimizer.load_state_dict(checkpoint["optimizer"])
start_epoch = checkpoint["epoch"] + 1
model.eval()
只做推理时可以只保存模型 state_dict。要无缝续训,还应保存 scheduler、混合精度 scaler、随机状态和数据划分标识。加载外部文件前确认来源可信,并以当前 PyTorch 文档为准处理 torch.load 的安全选项。
还要注意,best_state = model.state_dict() 保存的是对当前状态的引用;如果训练继续进行而没有立刻写盘,应使用 copy.deepcopy(model.state_dict()),否则“最佳模型”可能随着后续训练一起变化。
7. Device 与 GPU:模型和数据必须在同一设备
if torch.cuda.is_available():
    device = torch.device("cuda")
elif torch.backends.mps.is_available():
    device = torch.device("mps")
else:
    device = torch.device("cpu")

model = model.to(device)

for X, y in loader:
    X = X.to(device)
    y = y.to(device)
    logits = model(X)
.to(device) 返回位于目标设备的张量;对 tensor 写 X.to(device) 却不接收返回值,X 仍在原设备。.cuda() 是 CUDA 专用快捷方式,.to(device) 更便于 CPU/GPU 统一和多卡编号。
只有同一运算的张量都在同一 device 上才能计算。频繁把小张量 .cpu().numpy() 或 .item() 会触发设备同步,成为性能瓶颈;日志应适度聚合后再传回 CPU。
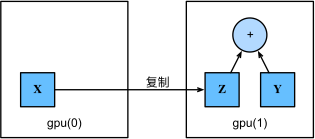
多个 CUDA 设备用 cuda:0、cuda:1 区分。跨 GPU 的普通算术默认不允许;.to(...)、.cuda(...) 等复制操作是例外。训练循环里应让模型、输入和标签长期驻留在目标设备,避免每一层或每个标量都来回传输。
行列数事先不确定时怎样拼接
不要在循环里反复 torch.cat/np.concatenate:每次都要重新分配并复制之前的全部结果,累计成本可能接近平方级。若最终 shape 可计算,先 empty 预分配再按切片写入;若确实未知,先把每块放入 Python list,循环结束后只 torch.cat(chunks, dim=...) 一次。数据量超出内存时应流式写入分块文件或增量存储,而不是构造一个无限增长的大矩阵。拼接前除目标维以外的 shape 必须一致。
8. 房价预测:表格数据的完整流程
房价预测把工程中的关键边界放在同一任务里。假设训练表有标签 SalePrice,测试表没有:
train_features = train_df.drop(columns=["SalePrice"])
test_features = test_df.copy()
数值特征:只用训练集拟合规则
num_cols = train_features.select_dtypes(include="number").columns
means = train_features[num_cols].mean()
stds = train_features[num_cols].std().replace(0, 1)

train_features[num_cols] = (train_features[num_cols] - means) / stds
test_features[num_cols] = (test_features[num_cols] - means) / stds

fill_values = train_features[num_cols].mean()
train_features[num_cols] = train_features[num_cols].fillna(fill_values)
test_features[num_cols] = test_features[num_cols].fillna(fill_values)
实践中应先从原始训练部分计算填充值和缩放量,再固定应用。不能各自在训练集和测试集上标准化,否则同一数值在两边代表不同坐标。
类别特征与 one-hot
pd.get_dummies 会受 pandas 版本、类别 dtype、缺失值选项和数据中实际类别集合影响。最关键的是让训练与测试列严格对齐:
all_raw = pd.concat([train_features, test_features], axis=0)
all_encoded = pd.get_dummies(all_raw, dummy_na=True, dtype="float32")

n_train = len(train_features)
X_train_df = all_encoded.iloc[:n_train]
X_test_df = all_encoded.iloc[n_train:]
竞赛中把无标签测试特征一起用于确定类别列通常不涉及标签泄漏,但严格生产流程更稳妥的做法是:只在训练集拟合类别词表,为未知类别保留专门编码,再 reindex 测试列。无论采用哪种协议,都要在实验记录中说明。
旧教程里固定出现“331 列”不代表任何环境都必须相同:pandas 版本、源数据版本、dummy_na、数值/类别 dtype 判断都可能改变列数。应该验证列名、dtype 和对齐关系,而不是追逐一个硬编码数字。
转换 tensor 前保证没有 object dtype:
X_train = torch.tensor(X_train_df.to_numpy(dtype="float32"))
X_test = torch.tensor(X_test_df.to_numpy(dtype="float32"))
y_train = torch.tensor(train_df["SalePrice"].to_numpy(dtype="float32"))
numpy.object_ 转换错误通常意味着混入字符串、布尔扩展类型或未编码类别。先检查 df.dtypes 和非数值列,不能靠强制 torch.tensor(..., dtype=...) 猜测修复。
One-hot 的内存边界
低基数类别适合 one-hot;高基数列会产生巨大稀疏矩阵。可选方案包括:
- 删除无意义的 ID;
- 合并罕见类别并设置 unknown;
- 使用稀疏表示;
- 对类别索引使用 embedding;
- 使用适合类别特征的树模型或专门编码器。
合并大表再 one-hot 还会产生中间副本,应估算 rows × columns × bytes_per_value,尽早转成 float32。
K 折、选型与最终重训
在每一折内部重新拟合预处理器和模型;用验证 log-RMSE 比较学习率、权重衰减、epoch 等方案。选定配置后,在全部有标签训练数据上从头重训,再预测无标签测试集。提交文件只是推理产物,不是新的训练标签。
9. 环境隔离、版本与 Jupyter kernel
“终端里安装成功,Notebook 仍然 import 失败”通常因为安装命令和 kernel 使用的不是同一个解释器。先在 Notebook 检查:
import sys, torch
print(sys.executable)
print(torch.__version__)
一个可复现项目至少记录:
- Python、PyTorch、pandas、D2L 的版本;
- CPU/CUDA 平台信息;
- 依赖锁文件或环境文件;
- Notebook 选择的 kernel;
- 随机种子、数据版本、划分方法和关键配置。
D2L 的书稿、d2l 包与 PyTorch API 都会演化。旧 Notebook 的输出列数、默认 dtype、函数签名或 .data 写法不能被当成当前行为的唯一标准;先区分“概念是否改变”和“接口是否改变”。
10. 分布偏移与 AutoML 的正确位置
训练与部署分布不一致时,模型即使在验证集上很好也可能失败:
- 协变量偏移:$P(X)$ 变了,但 $P(Y\mid X)$ 近似不变;
- 标签偏移:$P(Y)$ 变了,但 $P(X\mid Y)$ 近似不变;
- 概念偏移:$P(Y\mid X)$ 本身改变。
工程上需要监控输入范围、类别未知率、预测分布和延迟标签表现,并让验证划分尽量模拟部署条件。
AutoML 可以自动搜索预处理、模型和超参数,适合作为强基线与搜索工具;它不会自动修复数据泄漏、错误指标、分布偏移或不合理任务定义。搜索空间和验证协议若错,自动化只会更快地选出错误答案。
11. 让代码和知识长期可用
建议把一次实验拆成四类可追踪对象:
- 源代码:模型、数据管道、训练入口;
- 配置:超参数、路径的相对约定、随机种子;
- 环境:依赖锁定与硬件信息;
- 产物:checkpoint、指标、图表和简洁结论。
Notebook 适合探索和解释,正式训练逻辑应逐步抽到可测试的模块中。知识记录不要只保存“最后能跑的代码”,还要写明 shape、假设、验证协议和曾经踩过的坑;这正是本系列把对话与 Notebook 重组为文章的目的。
本篇知识链总结
nn.Module 让参数和子块成为可递归管理的树;注册决定参数能否被优化、保存和迁移;初始化与延后初始化解决模型建立时的尺度和 shape;自定义层扩展计算,state_dict 与 device 管理让训练可恢复、可部署。这正是 D2L“深度学习计算”的完整链路。模型之外,预处理器、数据划分、环境版本和监控同样是系统状态。只有它们共同被记录和验证,一段 Notebook 才真正成为可复现建模流程。
常见误区
- 把子层放进普通 list,导致参数未注册。
- 直接调用
forward,绕过Module.__call__的框架机制。 - 在自定义层中使用
.data参与前向计算。 - 把“值相同”误认为“共享同一个 Parameter”。
- 在 Lazy module 完成 dry run 前读取参数 shape 或执行自定义初始化。
X.to(device)后不接收返回值。- 只保存模型参数,却期望无缝恢复优化器动量和训练轮数。
- 在测试集上分别拟合标准化或类别编码规则。
- 看到 one-hot 列数与教程不同就认为 PyTorch 出错,而不检查 pandas、数据和 dtype。
- 把 AutoML 当成数据质量和验证设计的替代品。
系列导航
- 上一篇:多层感知机、泛化与稳定训练
- 系列总览
- 下一篇:CNN:从卷积到 DenseNet
对应章节与参考资料
- D2L:深度学习计算总览、层与块、参数管理、延后初始化、自定义层、读写文件、GPU
- D2L 扩展:Kaggle 房价预测、环境和分布偏移
- PyTorch:
ModuleList、state_dict保存与加载、CUDA 语义、Lazy modules